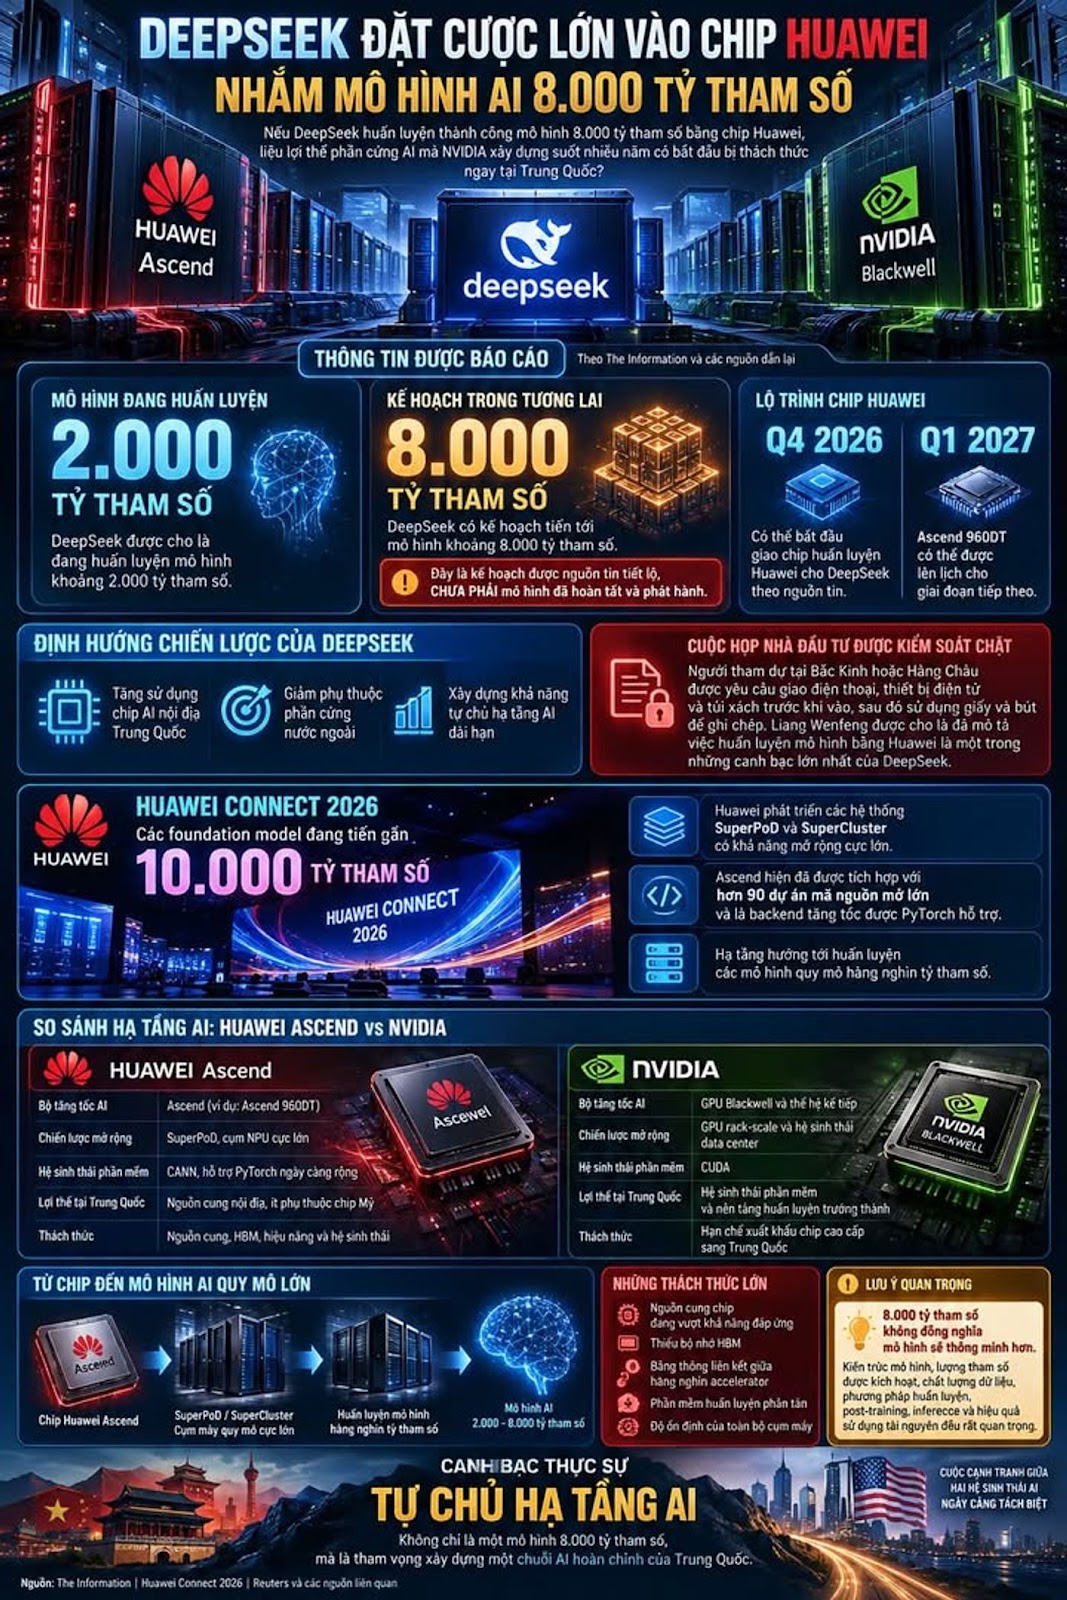
Nếu DeepSeek thực sự huấn luyện được mô hình 8.000 tỷ tham số bằng chip Huawei, lợi thế phần cứng AI mà NVIDIA xây dựng suốt nhiều năm có bắt đầu bị thách thức ngay tại Trung Quốc?
DeepSeek đang chuẩn bị cho một trong những bước đi tham vọng nhất kể từ khi nổi lên trên bản đồ AI toàn cầu. Theo The Information và các nguồn dẫn lại báo cáo này, nhà sáng lập Liang Wenfeng đã nói với các nhà đầu tư rằng mở rộng việc sử dụng chip AI nội địa, đặc biệt là bộ xử lý Huawei, cho quá trình huấn luyện mô hình đang trở thành một ưu tiên chiến lược của công ty.
Điểm đáng chú ý nhất không chỉ nằm ở việc DeepSeek muốn giảm phụ thuộc vào phần cứng nước ngoài. Công ty được cho là đang huấn luyện một mô hình khoảng 2.000 tỷ tham số và có kế hoạch tiến tới mô hình khổng lồ khoảng 8.000 tỷ tham số. Đây hiện vẫn là kế hoạch được nguồn tin tiết lộ từ cuộc họp kín, chưa phải thông số của một mô hình DeepSeek đã hoàn tất và phát hành.
Hạng mục Thông tin được báo cáo
Mô hình DeepSeek đang huấn luyện Khoảng 2.000 tỷ tham số
Mô hình quy mô lớn trong kế hoạch Khoảng 8.000 tỷ tham số
Hướng phần cứng Tăng sử dụng chip AI Trung Quốc
Nhà cung cấp đáng chú ý Huawei
Lô chip huấn luyện Huawei mới Có thể bắt đầu từ quý IV năm 2026
Giai đoạn tiếp theo Có thể kéo sang quý I năm 2027
Mục tiêu chiến lược Tăng khả năng tự chủ hạ tầng AI
Theo The Information, cuộc họp với nhà đầu tư được kiểm soát khá chặt. Người tham dự tại Bắc Kinh hoặc Hàng Châu được yêu cầu giao điện thoại, thiết bị điện tử và túi xách trước khi vào, sau đó sử dụng giấy và bút để ghi chép. Trong cuộc họp này, Liang Wenfeng được cho là đã mô tả việc huấn luyện mô hình bằng Huawei và các bộ xử lý Trung Quốc khác là một trong những canh bạc lớn nhất của DeepSeek.
Đây là sự thay đổi rất đáng chú ý. Chip AI Trung Quốc trước đây dễ được triển khai hơn cho inference, tức giai đoạn mô hình đã được huấn luyện và bắt đầu xử lý yêu cầu của người dùng. Huấn luyện một mô hình cực lớn lại khó hơn nhiều vì cần hàng nghìn đến hàng trăm nghìn bộ tăng tốc hoạt động đồng thời, bộ nhớ băng thông cao, mạng kết nối cực nhanh và một hệ sinh thái phần mềm đủ ổn định.
DeepSeek vì vậy không đơn giản chỉ thay một GPU NVIDIA bằng một chip Huawei.
Nếu muốn chuyển những mô hình hàng nghìn tỷ tham số sang hạ tầng nội địa, công ty phải giải quyết đồng thời hiệu năng chip, khả năng mở rộng cụm máy, băng thông bộ nhớ, tốc độ liên kết giữa các accelerator, phần mềm huấn luyện phân tán và độ ổn định của toàn bộ hệ thống.
Huawei đang chuẩn bị chính xác cho cuộc chơi đó. Tại HUAWEI CONNECT 2026, hãng cho biết các mô hình tiên tiến đang tiến gần quy mô 10.000 tỷ tham số. Huawei đồng thời phát triển các hệ thống SuperPoD và kiến trúc kết nối quy mô cực lớn thay vì chỉ cố cạnh tranh bằng hiệu năng của từng chip riêng lẻ.
Cuộc đua hạ tầng AI Huawei NVIDIA
Bộ tăng tốc AI Ascend GPU Blackwell và thế hệ kế tiếp
Chiến lược mở rộng SuperPoD, cụm NPU cực lớn GPU rack-scale và hệ sinh thái data center
Hệ sinh thái phần mềm Ascend, CANN, hỗ trợ PyTorch ngày càng rộng CUDA
Lợi thế tại Trung Quốc Nguồn cung nội địa, ít phụ thuộc chip Mỹ Hệ sinh thái phần mềm và nền tảng huấn luyện trưởng thành
Thách thức Nguồn cung, HBM, hiệu năng và hệ sinh thái Hạn chế xuất khẩu chip cao cấp sang Trung Quốc
Huawei cho biết Ascend hiện đã được tích hợp với hơn 90 dự án mã nguồn mở lớn và được hỗ trợ như một backend tăng tốc cho PyTorch. Đây là yếu tố đặc biệt quan trọng bởi khoảng cách giữa Huawei và NVIDIA không chỉ nằm ở silicon. CUDA và hệ sinh thái phần mềm khổng lồ xung quanh NVIDIA từ lâu là một trong những rào cản lớn nhất đối với các đối thủ.
Nhưng DeepSeek còn đối mặt một vấn đề khác là nguồn cung.
Reuters cho biết nhu cầu thiết bị AI Huawei tại Trung Quốc đang vượt khả năng cung ứng. Tình trạng thiếu bộ nhớ HBM cũng gây áp lực lên ngành chip AI Trung Quốc. Trong tháng 9/2026, giá một số bộ tăng tốc AI nội địa đã tăng đáng kể khi nguồn HBM trở thành nút thắt quan trọng.
Điều đó khiến câu chuyện 8.000 tỷ tham số trở nên đáng chú ý hơn nhiều so với một cuộc chạy đua thông số đơn thuần.
Một mô hình có nhiều tham số hơn không mặc nhiên thông minh hơn. Kiến trúc mô hình, lượng tham số thực sự được kích hoạt, chất lượng dữ liệu, phương pháp huấn luyện, post-training, inference và hiệu quả sử dụng tài nguyên đều có thể quan trọng không kém tổng số tham số.
Vì vậy, con số 8.000 tỷ không thể được sử dụng để kết luận DeepSeek sẽ mạnh hơn OpenAI, Anthropic, Google hay các đối thủ khác.
Điều quan trọng hơn nằm ở hạ tầng phía sau.
Nếu DeepSeek chứng minh rằng những mô hình thuộc quy mô hàng nghìn tỷ tham số có thể được huấn luyện hiệu quả trên một hệ thống phần cứng chủ yếu do Trung Quốc phát triển, Huawei sẽ có được một khách hàng và một bài kiểm chứng thực tế cực kỳ quan trọng cho Ascend.
Ngược lại, nếu nguồn cung chip, HBM, phần mềm hoặc hiệu quả của cụm máy trở thành nút thắt, dự án DeepSeek cũng có thể phơi bày khoảng cách thực tế giữa tham vọng tự chủ AI của Trung Quốc và hệ sinh thái NVIDIA.
DeepSeek vì vậy đang đặt cược vào thứ lớn hơn một mô hình 8.000 tỷ tham số.
Canh bạc thực sự là liệu Trung Quốc có thể xây dựng một chuỗi AI hoàn chỉnh từ chip, cụm máy, mạng kết nối, framework cho tới mô hình nền tảng mà không còn phải phụ thuộc quyết định vào phần cứng AI cao cấp của Mỹ hay không.
Nếu canh bạc này thành công, cuộc cạnh tranh tiếp theo sẽ không còn đơn thuần là DeepSeek đấu với OpenAI hay Huawei đấu với NVIDIA. Đó sẽ là cuộc cạnh tranh giữa hai hệ sinh thái hạ tầng AI ngày càng tách biệt của Trung Quốc và Mỹ.